
GPU-Server
Eigen GPU's.
Zonder wachtrij.
NVIDIA RTX PRO 4000 en 6000 Blackwell, van één kaart tot vier kaarten met 384 GB VRAM in één machine. Voor AI-inferentie, fine-tuning, rendering en video, per maand, in de EU, zonder egress-kosten.

NVIDIA RTX PRO 6000 Blackwell.
96 GB pro Karte.
De snelste professionele GPU van dit moment, in onze dedicated servers (Max-Q, één tot vier kaarten) en in enterprise-trajecten als Server Edition met tot acht kaarten per systeem. Eigen hardware in de EU, per maand, zonder egress-kosten.
- 96 GBGDDR7 ECC pro Karte
- 5. Gen.Tensor-Cores · FP4
- 4. Gen.RT-Cores
- 1 bis 8Karten pro System
Hardware von
Eigen modellen draaien (Llama, Mistral, Whisper, Stable Diffusion) zonder per token te betalen. 24 GB VRAM volstaat voor 7B tot 13B-modellen; 96 GB voor 70B in 4-bit.
LoRA en QLoRA op je eigen data, met je data in de EU. Vier kaarten met NVLink-achtige bandbreedte voor grotere runs.
Blender, Unreal, DaVinci, transcoding: RT-cores en NVENC, de hele nacht door, zonder dat je werkstation blokkeert.
ECC-geheugen voor berekeningen die kloppen. Remote desktop erop en je team werkt vanaf elke laptop.
Vier GPU's. 384 GB VRAM. Eén machine.
Vier NVIDIA RTX PRO 6000 Blackwell Max-Q in één dedicated server: draai meerdere taalmodellen naast elkaar (klantenservice, codehulp, documentverwerking), of één groot model voor honderden gelijktijdige gebruikers. Open-weight modellen als GLM, Mistral en Qwen op eigen hardware in de EU: je documenten, klantdata en broncode blijven binnen je eigen omgeving.
GEX430 bestellen · € 5.413,95 p/m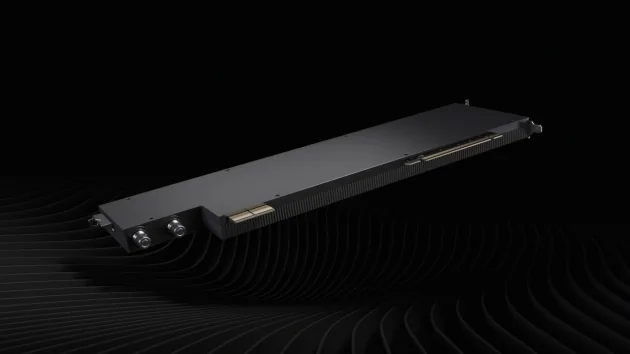
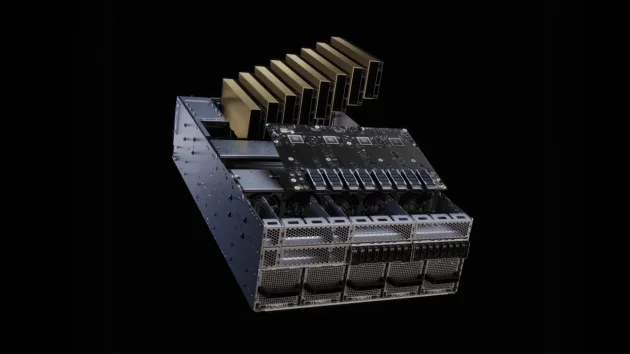
Tot acht Server Edition-GPU's per systeem, als eigen cluster.
Voor inferentie op schaal, training of een eigen AI-fabriek bouwen we een omgeving op maat: systemen met tot acht RTX PRO 6000 Blackwell Server Edition-kaarten, snelle netwerkkaarten, opslag en de software eromheen (Kubernetes, vLLM, monitoring). Vanaf € 100.000 eenmalig en € 10.000 per maand, inclusief beheer.
Enterprise-infrastructuurDe GPU-servers
Dedicated, met de volledige kaart voor jou alleen. Ubuntu met NVIDIA-drivers en CUDA kant-en-klaar bij beheerd.
 GEX45-1AI, rendering, videoop aanvraag
Intel Core i5-13500 14 Corecores14 cores
ram64 GB DDR4
opslag2 x 512 GB NVMe
RTX 4000 SFF Blackwell Generation
€ 336,95root · beheerd € 410,95setup € 250,95 eenmalig
Bestellen
GEX63-1AI, rendering, videoop aanvraag
Intel Core Ultra 7 265 20-Corecores20 cores
ram128 GB DDR5
opslag2 x 1.92 TB NVMe
RTX PRO 6000 Blackwell Max-Q
€ 1.513,95root · beheerd € 1.587,95setup € 1.198,95 eenmalig
Bestellen
GEX131-1AI, rendering, videoop aanvraag
Intel Xeon Gold 5412U 24-Corecores24 cores
ram256 GB DDR5 ECC reg.
opslag2 x 960 GB NVMe
RTX PRO 6000 Blackwell Max-Q
€ 2.263,95root · beheerd € 2.337,95setup € 1.798,95 eenmalig
Bestellen
GEX131-2AI, rendering, videoop aanvraag
Intel Xeon Gold 5412U 24-Corecores24 cores
ram512 GB DDR5 ECC reg.
opslag2 x 1.92 TB NVMe
RTX PRO 6000 Blackwell Max-Q
€ 3.163,95root · beheerd € 3.237,95setup € 2.518,95 eenmalig
Bestellen
GEX131-3AI, rendering, videoop aanvraag
Intel Xeon Gold 5412U 24-Corecores24 cores
ram768 GB DDR5 ECC reg.
opslag4 x 3.84 TB NVMe
RTX PRO 6000 Blackwell Max-Q
€ 4.063,95root · beheerd € 4.137,95setup € 3.238,95 eenmalig
Bestellen
GEX430-1AI, rendering, videoop aanvraag
Intel Xeon Gold 5412U 24-Corecores24 cores
ram128 GB DDR5 ECC reg.
opslag2 x 1.92 TB NVMe
4x RTX PRO 6000 Blackwell Max-Q
€ 5.413,95root · beheerd € 5.487,95setup € 4.318,95 eenmalig
Bestellen
Häufige Fragen
Staan de drivers er al op?
Bij beheerd zetten wij Ubuntu met de NVIDIA-driver, CUDA en Docker met de NVIDIA-runtime klaar; je kunt meteen een container starten. Bij root doe je het zelf (nvidia-driver via apt is tien minuten werk).
Kan ik per uur betalen?
Wij factureren per maand; per maand opzegbaar. Voor een paar uur rekenwerk is een cloud-GPU goedkoper; voor alles wat langer dan een week draait is een eigen kaart vele malen goedkoper.
Welke kaart voor welk model?
RTX PRO 4000 (24 GB): modellen tot ±13B, Whisper, beeldgeneratie. RTX PRO 6000 (96 GB): 70B in 4-bit, grotere batch-inferentie, fine-tuning. Vier keer 6000: training en multi-GPU-inferentie.
Waar staan de servers?
In Helsinki of Falkenstein, binnen de EU. Je data verlaat Europa niet.
Kunnen jullie het model voor me opzetten?
Ja, als interim- of projectwerk: van vLLM en Ollama tot een eigen API met rate-limiting. Stuur een bericht met wat je wilt draaien.
Twijfel je over de kaart?
Vertel wat je wilt draaien, wij rekenen uit welke GPU en hoeveel VRAM je nodig hebt.
